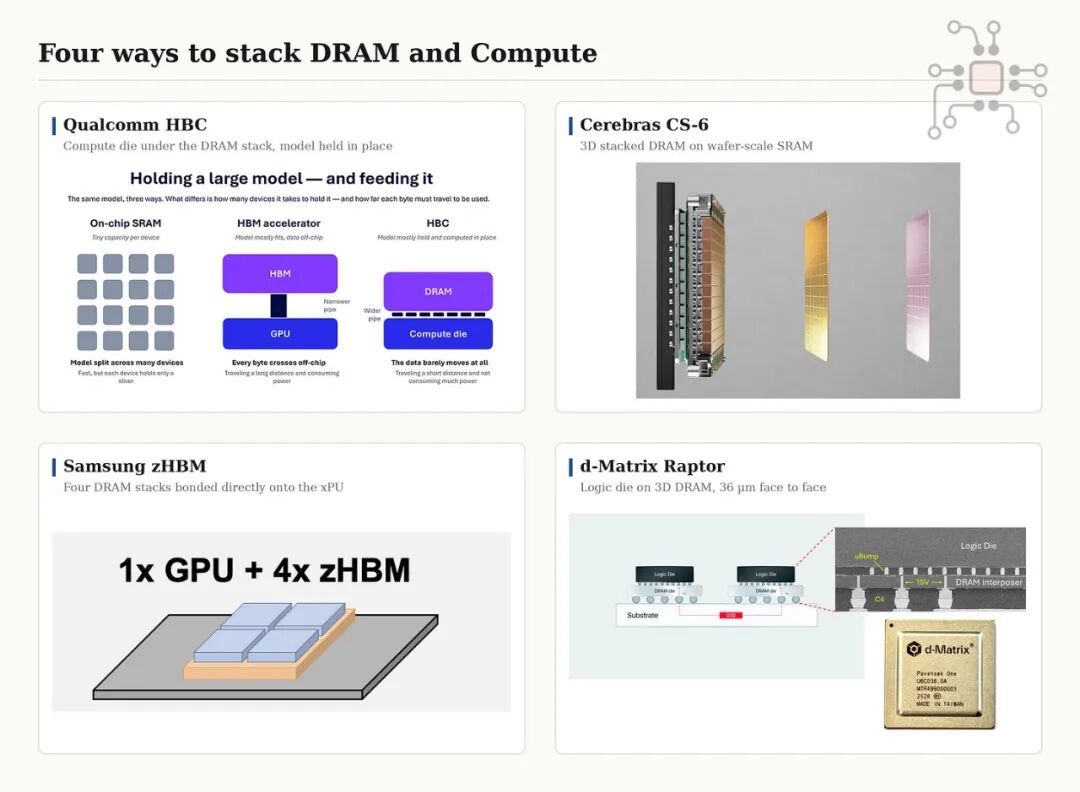
近几个月来体育游戏app平台,东说念主工智能推理加快器领域出现了一个较着的趋势。多家公司已在其发展路子图中示意,将DRAM和揣测智商堆叠起来。
高通发布了HBC (高带宽揣测)本事,随后在Hot Chips大会上,Cerebras透露CS-6芯片将在其揣测芯片上堆叠DRAM芯片。三星一直在不遗余力地现实其zHBM本事,并将其称为最终狡计。有传言称,Groq LP40也在考虑接管堆叠式DRAM。此外,d-Matrix在深度大会上展示了其第二代加快器Raptor,该加快器也接管了堆叠式DRAM ,并通告与NVIDIA成就合营联系。
在本文中,我将进展这一趋势的合感性。我将深切探讨三个具体原因。
1、3D DRAM 可结束性能最高的架构
2、3D DRAM 可将功耗贬低至 0.1 pJ/bit 以下,从而开释出更多功率预算用于揣测和齐集通讯。
3、与HBM不同,3D DRAM的访谒不错像SRAM通常结束细目性。
3D DRAM 大致结束最好、性能最高的架构
本年英伟达GTC大会上最精彩的要道莫过于两位科技界泰斗——英伟达首席科学家Bill Dally 和谷歌DeepMind前首席科学家Jeff Dean——之间的炉边言语。他们二东说念主对当代揣测的孝顺功不可没。在他们探讨的宽阔话题中,有一个不雅点弥远萦绕在他们心头——处理揣测最节能、性能最高的标准是将数据放在张量引擎独揽,尽量不要迁移它。
“连续情况下,对 NVFP4 进行乘加运算需要 10 飞焦耳的能量,而从 HBM4 读取这 4 位数据(每位耗能 3-4 皮焦耳)则需要大要 15 皮焦耳。这意味着从外部存储器读取一个 NVFP4 数值所需的能量是进行乘加运算的 1000 倍。然而,读取 SRAM 也只需要大要 10 飞焦耳的能量。降顽劣耗的重要在于幸免数据传输。”Billy Dally,GTC 2026
这基本上即是 Groq、Cerebras 和 d-Matrix 等加快器背后的架构理念,即 SRAM 与揣测单位位于归拢位置。然而,尽管 SRAM 在带宽、蔓延和每比特能耗方面较着优于 DRAM,但其容量很快就会铺张。3D DRAM 是结束下一阶段飞跃的独一途径,它既能保合手与 SRAM 附进的带宽,又能将容量陶冶一个数目级。
与基于 SRAM 的架构雷同,在 3D DRAM 中,每个张量中枢王人不错领有我方的专用内存块,并通过专用清澈进行读写操作。这种容量和带宽十足属于该张量中枢,这与 HBM 不同,HBM 的内存连续被视为一个长入的池,系数张量中枢分享归拢内存。
Jeff Dean 将这种在揣测端接管堆叠式 DRAM 的理念念架构比作一台弹珠机。你盛开闸门,数据就会像滚雪球通常落到专用的张量中枢。
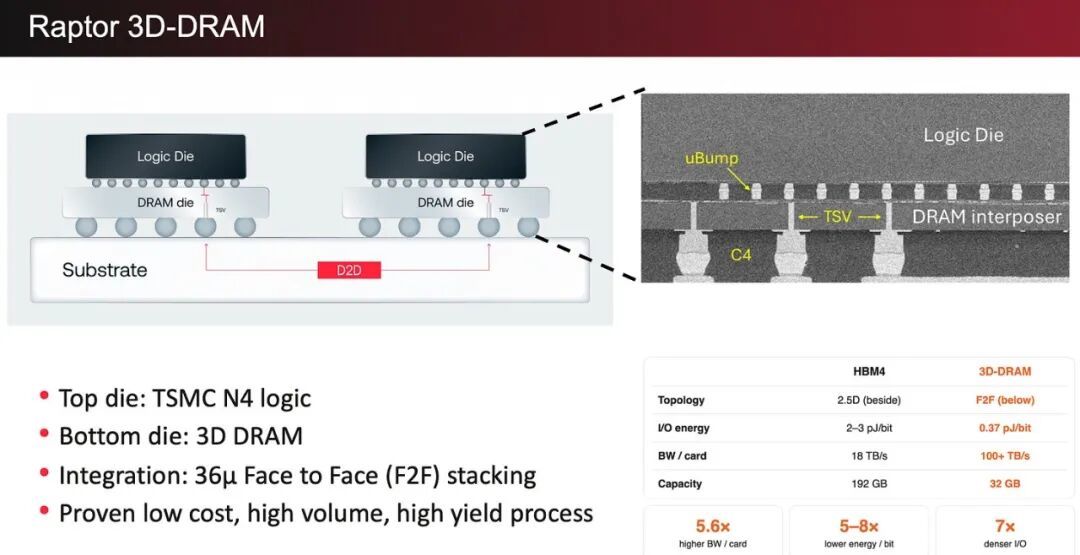
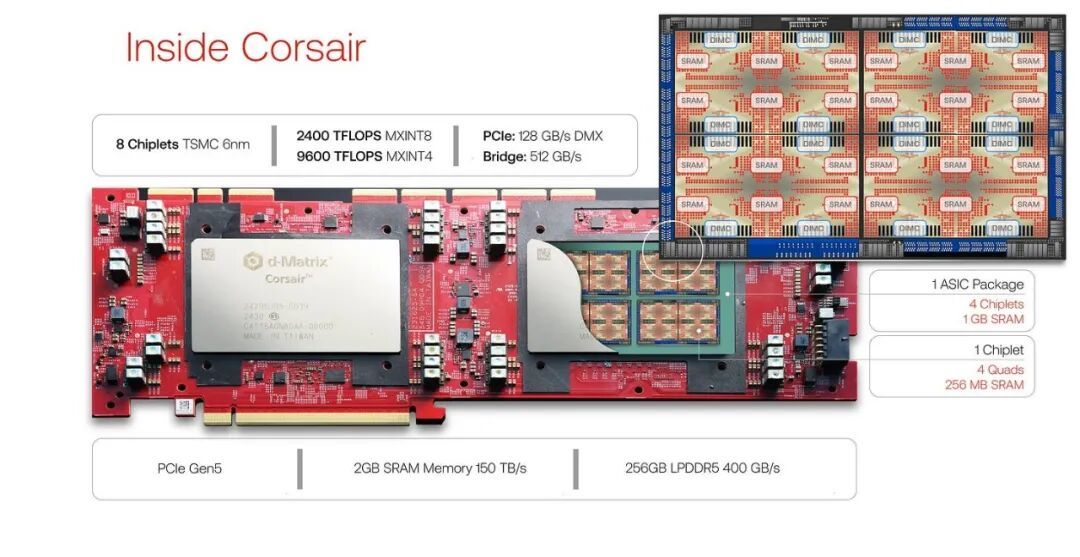
目下,让咱们仔细望望d-Matrix在Hot Chips大会上展出的Raptor加快器。它是首款公开了大批细节信息的3D DRAM加快器。
封装架构:每个 Raptor 封装包含 4 个芯片。
芯粒联想:该封装中的每个小芯片王人是“三明治”结构,由一个揣测芯片和一个堆叠的DRAM芯片组成。
揣测布局:每个芯片有 256 个张量引擎,每个引擎分拨有 3 个专用 DRAM 存储体,并有专用清澈进行读写操作。
互连:每个DRAM存储体王人有一条256位总线。也即是说,在单个芯片上,揣测单位和内存单位之间有196K条数据通说念。因此,每个张量引擎王人有一条768位总线相接到其专用DRAM。
One Raptor Chiplet = 256 Tensor Cores x 3 banks x 256 bit-bus/bank = 196K data lanes
One Raptor Package =4 chiplets x 196K = ~800K data lates
比较之下,Blackwell封装的GPU 与其 8 个 HBM3E 堆栈之间只消 8K 条数据通说念,而Rubin封装的 8 个 HBM4 堆栈也只消 16K 条数据通说念。
通说念数目增多一个数目级的上风在于,你不错让每条通说念以较低的频率运行,大要在 500-700 MHz 傍边,而无需像 HBM4 那样,每引脚 11 Gbps 以上的带宽以及由此带来的信号完好意思性/性能完好意思性 (SI/PI) 和联想复杂性。以如斯低的频率运行 196K 条通说念还有另一个远大的上风,咱们将不才一节中预防先容。
至于数字方面,
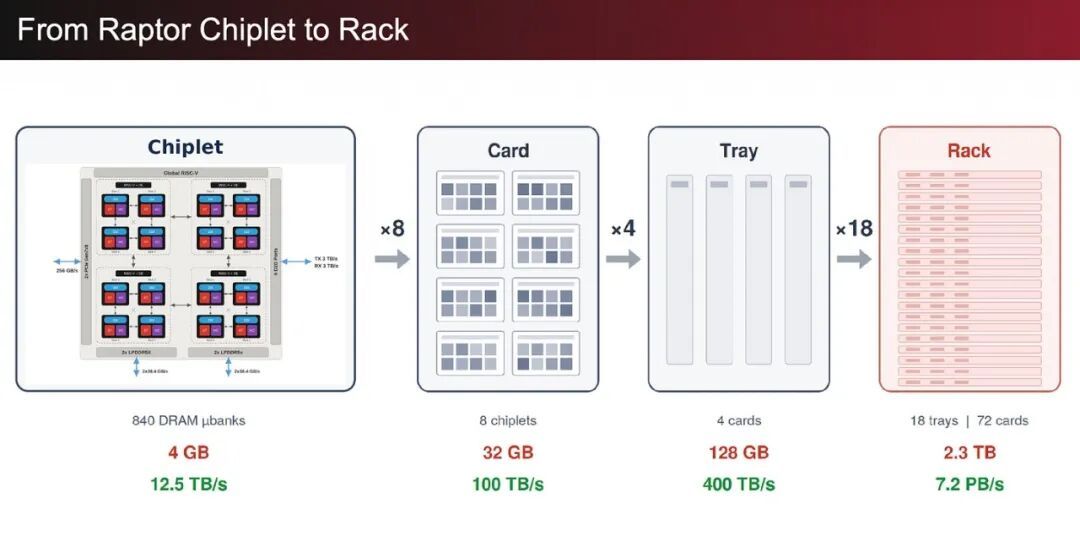
1、d-Matrix 声称其性能基于每对芯片(8 个芯片组),如下图所示。这对芯片可提供特出 100 TB/s 的内存带宽;
2、与第一代 Corsair 加快卡的 2GB SRAM 比较,Raptor 将配备 32GB 堆叠式 DRAM;
3、在机架层面,18 个揣测托架,每个托架配备 8 个 Raptor 封装,统共可提供 2.3TB 的 3D-DRAM 容量和 7.2 PB/s 的内存带宽。比较之下,配备 72 个 Rubin GPU 的 NVL 机架的 HBM4 带宽为 1.6 PB/s;
而这只是是第一代基于 3D-DRAM 的加快器。
重要在于:多家公司已预防进展了基于SRAM的推理加快器的上风。从发展路子图来看,3D DRAM是结束下一步飞跃的独一途径,它既能保合手与SRAM雷同的带宽,又能陶冶容量。
3D DRAM 可将功耗贬低至 < 0.1 pJ/bit
功耗角度其实很容易相识。
在HBM中,DRAM阵列自己的能耗并非问题地方。信得过的问题在于通过中介层在内存堆栈和揣测芯片之间传输数据。克服如斯大的电容需要大功率驱动器,况且旅途上的每一段王人会增多能耗——数据横向穿过HBM基片到达凸点,向下穿过中介层,再朝上到达揣测芯片的凸点,然后再次横向穿过揣测芯片到达狡计位置。系数这些门径加起来,每比特的能耗约为2.5 pJ。
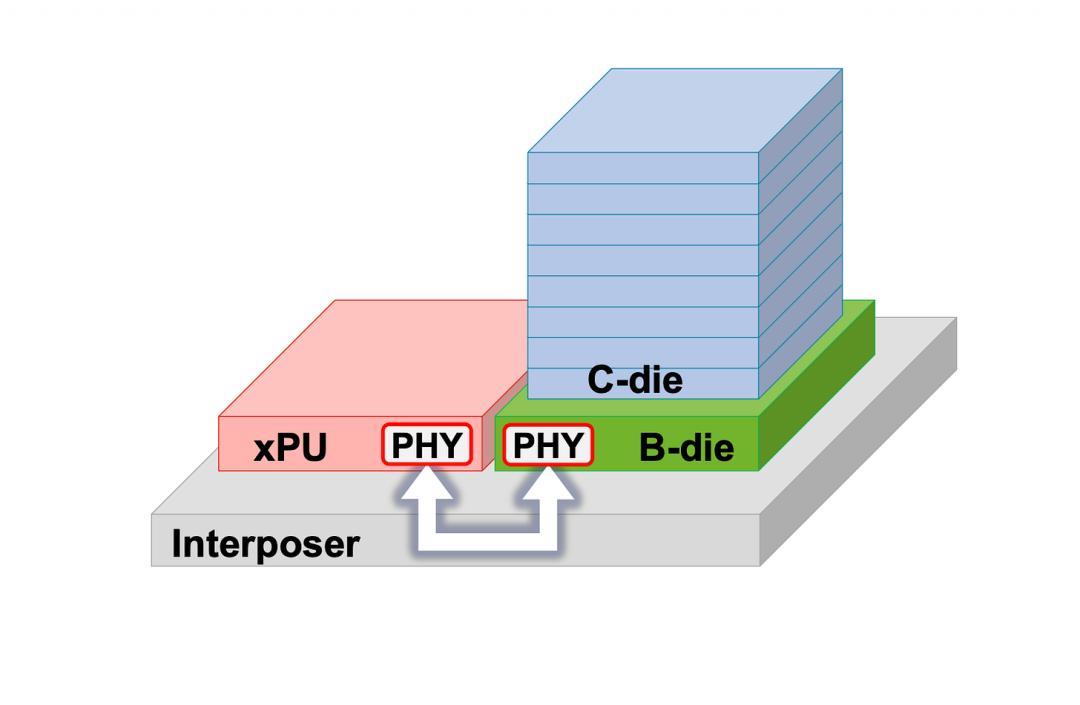
当DRAM径直堆叠在揣测芯片上时,很容易念念象数据从DRAM位单位到揣测实施点之间的传输距离有何等短。这么就十足省去了中介层,功耗降至0.35-0.4 pJ/bit。
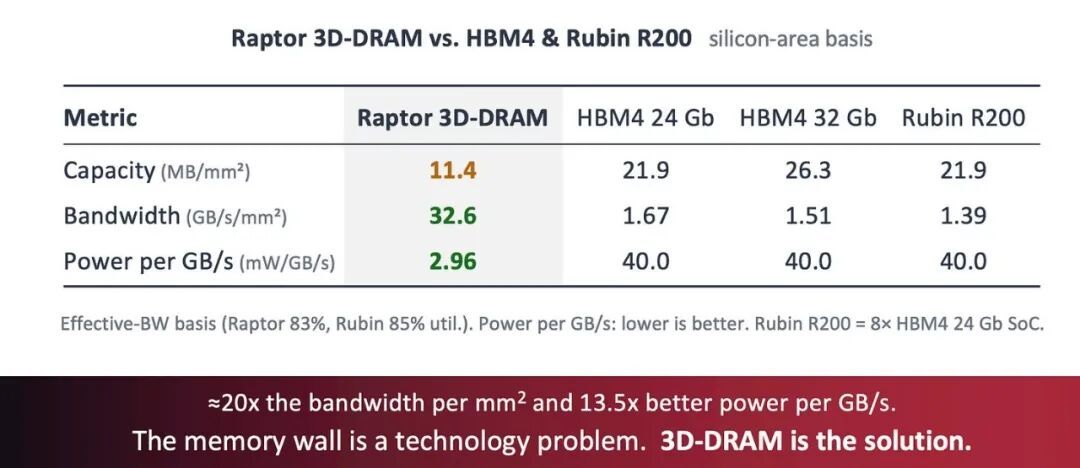
为了更直不雅地相识 2.5 pJ/bit 与 0.4 pJ/bit 的分手,咱们不错将其乘以带宽,换算成瓦特。从 HBM 堆栈中索求 100 TB/s 的数据需要 2000W 的功耗,而从 3D DRAM 中索求则需要 296W。请仔细念念念念,从 HBM 中索求 100 TB/s 的数据所需的功耗比从 3D DRAM 中索求跨越一个数目级。下文将预防先容这些数字的推导经由。
HBM power for 100TB/s = 2.5 pJ/bitx 100 TB/s x 8 bits = 2000W
3DD power for 100TB/s = 0.37 pJ/bit x 100 TB/s x 8 bits = 296W
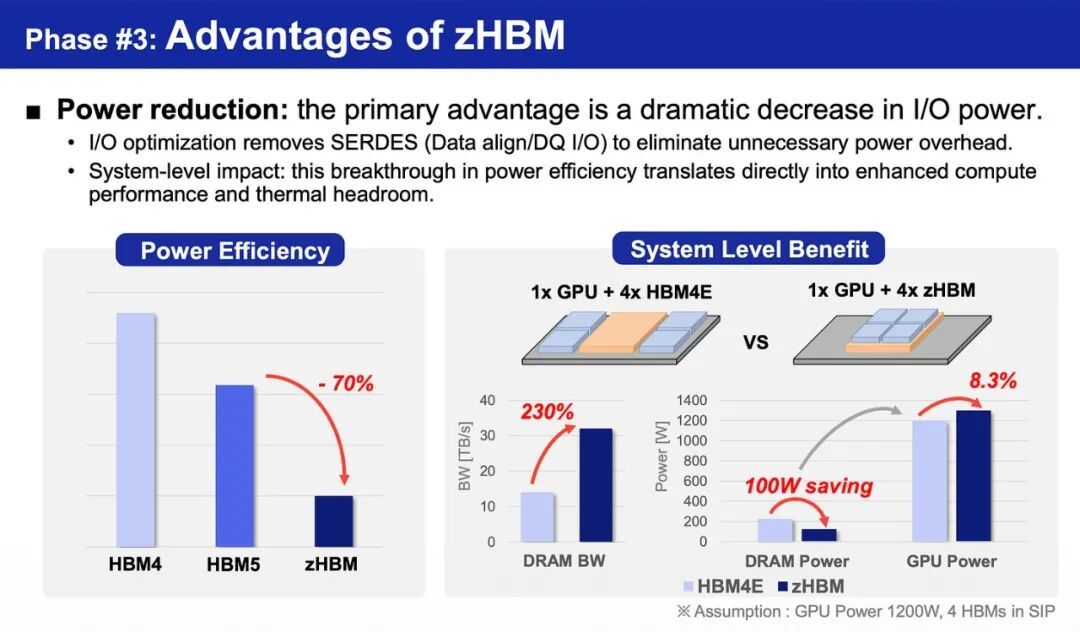
在三星的 zHBM 展示中也能看到这少许。他们论证了在 1200W GPU 系统中,zHBM 省俭下来的功耗不错用于陶冶揣测智商。
但重要在于,0.37 pJ/bit 并不是最低值。
Raptor接管36微米间距的微凸点将两颗芯片键合在全部。在如斯小的焊盘独揽,一个4纳米晶体管驱动器显得非常轻微,而焊盘、其静电放电保护以及通往焊盘的布线,按像片上尺度来看,组成了一个较大的电容。DRAM侧的情况也雷同。
夹杂键合本事显耀松开了芯片尺寸。引脚间距从 36 微米减小到个位数微米,焊盘尺寸也随之松开。揣测芯片中的驱动器与 DRAM 之间的布线距离大大裁减,电容也随之贬低。因此,能耗进一步从约 0.4 pJ/bit 降至约 0.1 pJ/bit。
3D DRAM的细目性
好的,我倾销的临了一部分是——DRAM 因其不细目性而恶名昭著。
HBM、LPDDR 和雷同的存储器在启动时会阅历一个称为检修和校准的运行化经由。在这个经由中,揣测芯片上的 HBM PHY 会运行读取中心化和写入中心化算法。它会将事先设定的样式写入存储器,然后读取这些样式,并扫描每条通说念上的相位旋转器,以找到数据眼的中心。我在这里对这个经由进行了简化形色。淌若您感兴味,我在其他著作中预防先容了其中的细节。
检修只是脱手。启动后,有三件事会导致DRAM处于不细目情状。
1、电压和温度的变化会导致最好眼图发生漂移,因此PHY需要按时再行校准。这是不细目性的起头之一。
2、刷新经由由温度规则。这是一项必要操作,但会径直贬低性能。
3、DRAM 对数据的存储和检索形势非常敏锐。由于 HBM 连续被视为长入内存,HBM 规则器会再行排序事务以最大化页面射中率和存储体瓜代。这使得任何读取申请的蔓延王人具有不细目性。
关于 3D DRAM 而言,这些问题要么不适用,要么很容易通过联想来贬责。
1、当DRAM径直与揣测芯片绑定时,由于距离极短,无需传统的HBM式PHY。这么就无需进行检修和校准,也无需考虑走线长度。揣测芯片和内存芯片之间的接口通过静态时序分析结束闭合,因此这种联想偶然被称为无PHY联想。
2、在 3D DRAM 中,每个存储体王人很浅,因此咱们不错将刷新率设立为富裕高的频率,而不会对性能形成太大影响。
3、每个张量引擎王人有其专属的旅途和引脚相接到其存储体,与其他张量引擎不分享任何旅途和引脚。因此,规则器非常爽脆,无需进行任何契机性的事务重排序。这使得访谒蔓延是细目性的。
重要在于:SRAM 的细目性动作具有诸多上风,而 3D DRAM 则以 HBM 无法企及的形势保合手了这种特质。需要提神的是,DRAM 本事自己对数据的存储和检索形势非常敏锐。与 SRAM 不同,SRAM 的访谒样式不足轻重,而任何类型的 DRAM,不管是 HBM 如故 3D DRAM,王人需要软硬件协同联想,以便合理布局权重和键值缓存,从而最大化页面射中率。
论断
常见问题包括散热、冷却、翘曲、电源分拨齐集 (PDN) 和良率。这些问题王人很合理,况且王人是不错贬责的。业内大多数厂商依然在入部下手贬责这些问题。HBM5 展望将接管夹杂键合本事,这项本事正蓄势待发,行将插足老到阶段。
就散热而言,短期内咱们可能只可结束 4 层堆叠。8 层堆叠仍然存在一些需要工程贬责的问题。信得过的艰辛在于位于内存堆叠下方的揣测芯片的功率密度。DRAM 非常怕热,其功耗仅为 0.5 W/mm²,因此结束 4 层堆叠可能不行问题。而像 Rubin 这么的 GPU,功耗高达 1.5 W/mm²,可能很容易达到 2 层堆叠,但要结束 4 层堆叠则可能需要一些工程联想。
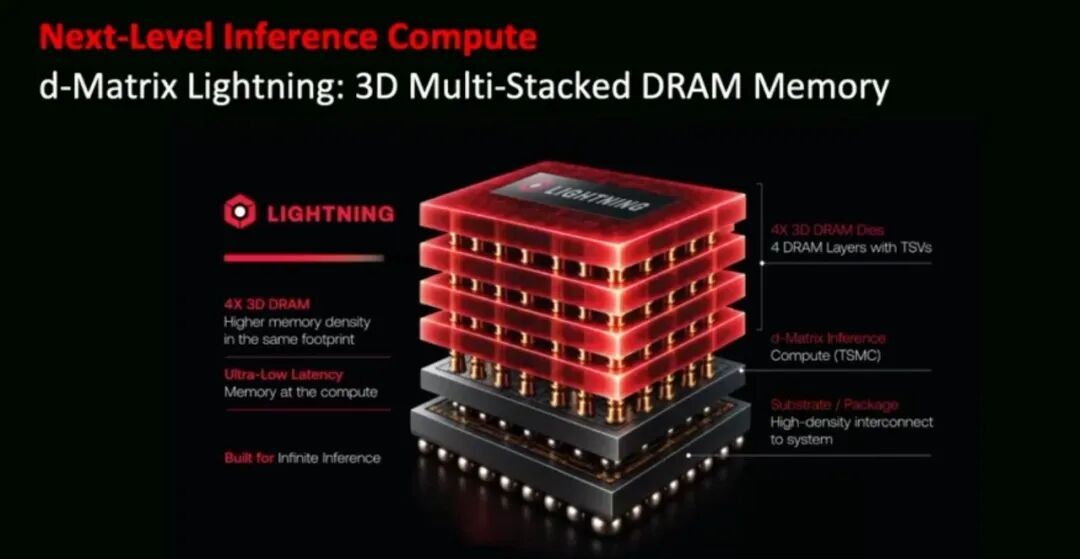
这些褒贬基于我的教训和直观。我念念抒发的更要紧的不雅点是:Raptor 只接管一层 DRAM,而自后续的 Lightning 加快器将接管四层 DRAM,这是有原因的。除此除外,还有好多工程方面的问题需要贬责。
本文来自微信公众号“半导体行业不雅察”(ID:icbank)体育游戏app平台,作家:Subbu,36氪经授权发布。